
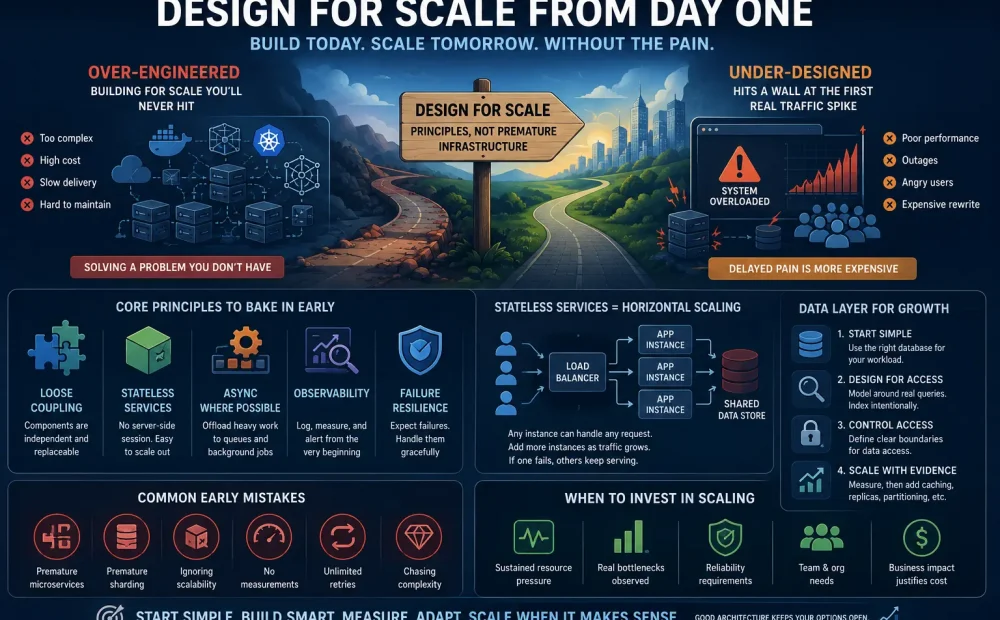
Команды разработчиков часто впадают в одну из двух крайностей: либо создают сложную инфраструктуру для миллионов пользователей, которые могут никогда не появиться, либо проектируют систему исключительно под текущую нагрузку и сталкиваются с серьёзными проблемами уже при первом заметном всплеске трафика. Проектирование с расчётом на масштабирование с первого дня не означает необходимость сразу внедрять все доступные технологии распределённых систем. Речь идёт о таких архитектурных решениях, которые сохраняют возможность роста и не вынуждают команду дорого переписывать систему в будущем.
Что на самом деле означает «проектировать с расчётом на масштабирование» на старте
На раннем этапе масштабируемость прежде всего означает отказ от архитектурных решений, которые неоправданно усложнят будущий рост, а не создание инфраструктуры под гипотетически огромный трафик.
Новому приложению редко нужна архитектура глобальной технологической платформы. Хорошо спроектированный монолит, работающий с обычной реляционной базой данных, способен выдерживать удивительно высокую нагрузку, при этом его обычно проще разрабатывать, тестировать, развёртывать и отлаживать, чем распределённый набор сервисов.
Главный вопрос заключается в том, сможет ли система развиваться.
Если логика приложения жёстко привязана к отдельным серверам, доступ к базе данных никак не контролируется, ресурсоёмкие операции блокируют пользовательские запросы, а каждый компонент напрямую зависит от множества других компонентов, рост трафика быстро выявит структурные проблемы. Добавление более мощного оборудования может временно помочь, но не устранит фундаментальные ограничения.
Масштабируемая архитектура предполагает понятные границы и предсказуемое поведение системы. Вычислительные мощности должно быть относительно легко увеличивать. Ресурсоёмкие операции, когда это возможно, следует отделять от интерактивных запросов. Работа с данными должна строиться по понятным правилам. А наблюдаемость системы должна позволять команде находить узкие места до того, как она начнёт менять архитектуру.
Такой подход сохраняет свободу выбора. Необязательно с первого дня внедрять шардинг, несколько регионов, Kubernetes, потоковую обработку событий или десятки микросервисов. Важно построить архитектуру так, чтобы при реальном росте переход к этим или другим решениям не оказался неоправданно болезненным.
Основные принципы, которые стоит заложить уже в первых архитектурных решениях
Самые ценные решения для будущего масштабирования — это простые принципы, которые уменьшают связанность компонентов, позволяют легче добавлять мощности и помогают инженерам понимать поведение системы под нагрузкой.
Особенно полезны пять принципов:
- Сохраняйте слабую связанность компонентов. Определяйте чёткие границы между основными частями приложения, чтобы один компонент можно было развивать без необходимости менять всю кодовую базу.
- По возможности используйте stateless-подход для вычислительных сервисов. Не привязывайте пользовательские сессии и критически важное состояние приложения к конкретному серверу. Тогда запросы будет значительно проще распределять между несколькими экземплярами приложения.
- Разделяйте синхронную и асинхронную работу. Операции, которые необязательно завершать до отправки ответа пользователю, часто можно переносить в фоновые задачи или очереди, снижая задержки и освобождая ресурсы для обработки запросов.
- Закладывайте наблюдаемость системы. Логи, метрики, трассировка, проверки состояния и уведомления следует внедрять достаточно рано, чтобы инженеры могли понимать, где именно расходуются время и ресурсы.
- Исходите из того, что зависимости будут давать сбои. Внешние API, базы данных, сети и внутренние сервисы могут замедляться или становиться недоступными. Тайм-ауты, ограниченные повторные попытки, идемпотентность и корректная обработка сбоев должны учитываться ещё до первой серьёзной аварии.
Эти принципы не требуют сложной архитектуры. Многие из них можно реализовать даже внутри относительно простого приложения.
Это важное различие: масштабируемость и архитектурная сложность — не одно и то же. Сложность сама создаёт дополнительные расходы: больше процессов развёртывания, больше потенциальных точек отказа, больше мониторинга, сетевых взаимодействий, требований к компетенциям команды и трудностей при отладке.
Поэтому цель заключается не в максимальной технологической сложности, а в минимально необходимой сложности с достаточным запасом для роста.
Stateless-сервисы и почему они важны для горизонтального масштабирования
Stateless-сервисы проще масштабировать горизонтально, поскольку любой доступный экземпляр приложения может обработать запрос без зависимости от информации, хранящейся исключительно на конкретном сервере.
Представим приложение, которое полностью хранит пользовательскую сессию в оперативной памяти сервера, обработавшего первый запрос. Если следующий запрос попадёт на другой сервер, тот может не знать, кто этот пользователь и что происходило ранее.
Одним из вариантов решения являются sticky sessions — механизм, при котором запросы конкретного пользователя стараются направлять на один и тот же сервер. Такой подход может работать, однако он создаёт дополнительные эксплуатационные ограничения и способен усложнять балансировку нагрузки и восстановление после сбоев.
Более масштабируемый вариант — хранить важное состояние за пределами отдельных экземпляров приложения. Информация о сессиях может находиться в общем хранилище, а постоянные бизнес-данные — в базе данных или другой подходящей системе хранения.
В таком случае экземпляры приложения становятся в значительной степени взаимозаменяемыми.
При росте трафика можно запускать дополнительные экземпляры и подключать их к балансировщику нагрузки. Если один экземпляр выходит из строя, запросы перенаправляются на другие. Когда нагрузка снижается, лишние мощности можно убрать.
Это и есть горизонтальное масштабирование: увеличение производительности за счёт добавления серверов или экземпляров приложения, а не постоянного наращивания ресурсов одной машины.
Stateless-подход не следует понимать буквально как «в приложении нет состояния». Практически любое полезное приложение работает с состоянием. Суть принципа заключается в том, чтобы экземпляры, обрабатывающие запросы, не владели критически важным состоянием, без которого другой экземпляр не сможет продолжить работу.
Этот же принцип оказывается полезным при развёртывании новых версий, автоматическом масштабировании, восстановлении после сбоев и, в дальнейшем, при построении мультирегиональной архитектуры.
Как построить слой данных с расчётом на будущий рост
Масштабируемый слой данных начинается с продуманной схемы, предсказуемых сценариев доступа и измерения нагрузки задолго до того, как системе понадобятся специализированные базы данных или шардинг.
Подготовку к росту можно разделить на четыре этапа:
- Начните с базы данных, соответствующей характеру нагрузки. Для многих транзакционных приложений зрелая реляционная база данных является хорошим вариантом по умолчанию. Не стоит выбирать специализированное распределённое хранилище исключительно потому, что когда-нибудь приложение теоретически может стать очень большим.
- Проектируйте схемы и индексы с учётом реальных сценариев доступа. Понимайте, как данные будут создаваться, запрашиваться, обновляться и удаляться. Правильные индексы и эффективные запросы часто позволяют значительно увеличить допустимую нагрузку без серьёзной перестройки архитектуры.
- Контролируйте доступ к слою данных. Не позволяйте несвязанным частям приложения выполнять произвольные запросы без понятных границ ответственности. Определённые правила доступа упрощают будущее внедрение кэширования, репликации, партиционирования и миграций.
- Масштабируйте на основе измеренных узких мест. Внедряйте кэширование, read replicas, партиционирование, специализированные хранилища или шардинг тогда, когда данные показывают, что более простых оптимизаций уже недостаточно.
О масштабировании баз данных часто говорят так, словно шардинг неизбежен. Для многих приложений это совсем не так.
Команда может обеспечить значительный рост благодаря оптимизации запросов, индексам, грамотному управлению соединениями, кэшированию, увеличению мощности серверов базы данных, репликам для чтения, архивированию и фоновой обработке — задолго до того, как потребуется распределять данные между несколькими серверами.
Архитектура данных также должна учитывать будущие миграции. Схемы меняются по мере развития продукта, а рост таблиц делает ранее простые миграции всё более дорогостоящими. Поэтому не стоит рассчитывать, что любое изменение схемы всегда будет выполняться мгновенно.
К кэшированию следует подходить столь же дисциплинированно. Оно способно существенно уменьшить повторную нагрузку на базу данных, но одновременно создаёт проблемы с инвалидацией, согласованностью и эксплуатацией. Кэшировать стоит то, что действительно приносит пользу согласно измерениям, а не использовать кэш как универсальную замену эффективной работе с данными.
Типичные ошибки масштабирования на ранних этапах проекта
Самые опасные ранние ошибки обычно возникают из-за оптимизации под воображаемые будущие требования или полного игнорирования архитектурной дисциплины только потому, что текущая нагрузка невелика.
Один из распространённых примеров — преждевременный переход к микросервисам. Разделение небольшого продукта на множество независимо развёртываемых сервисов может принести сетевые сбои, необходимость распределённой трассировки, service discovery, управление версиями, дублирование инфраструктуры и сложную локальную разработку задолго до того, как команда получит реальные преимущества независимого масштабирования.
Аналогичная проблема возникает с преждевременным шардингом. Распределение данных между несколькими узлами базы данных способно решить реальные проблемы с производительностью, но одновременно усложняет запросы, транзакции, миграции, резервное копирование и восстановление после сбоев. Внедрение шардинга без объективной необходимости может лишь замедлить развитие молодого продукта.
Есть и противоположная крайность — полное игнорирование масштабируемости. Команды хранят критически важные файлы на локальных дисках серверов приложения, выполняют тяжёлые отчёты прямо внутри синхронных веб-запросов, допускают неограниченные запросы к базе данных или создают процессы, способные работать только на одной машине.
Ещё одна ошибка — масштабирование без измерений. Команда может обвинять базу данных в низкой производительности, хотя настоящая причина заключается во внешнем API, неэффективном коде приложения, чрезмерной сериализации, плохих индексах или неправильно настроенном пуле соединений.
Без наблюдаемости изменения архитектуры превращаются в догадки.
Команды также нередко недооценивают каскадные сбои. Перегруженная зависимость начинает отвечать медленнее, вызывающие её компоненты агрессивно повторяют запросы, нагрузка возрастает ещё сильнее, и локальная проблема превращается в масштабный сбой. Тайм-ауты, ограничения повторных попыток, backoff, rate limiting и паттерн circuit breaker при грамотном использовании помогают снизить этот риск.
Наконец, инженеры иногда оптимизируют систему под максимальную теоретическую пропускную способность, забывая о сопровождаемости. Архитектура, способная выдерживать огромный трафик, но требующая для эксплуатации большой команды узкопрофильных специалистов, может оказаться совершенно неподходящей для компании, которая ещё даже не достигла product-market fit.
Когда действительно стоит инвестировать в инфраструктуру масштабирования, а когда лучше подождать
Инфраструктуру масштабирования следует внедрять тогда, когда её сложность оправдана измеренным спросом, требованиями к надёжности или эксплуатационными ограничениями, а не просто потому, что рост когда-нибудь возможен.
Самый очевидный сигнал — постоянная нехватка ресурсов. Если экземпляры приложения регулярно приближаются к пределам мощности, горизонтальное масштабирование может быть оправдано. Если процессор, пропускная способность хранилища, количество соединений, память или задержки запросов базы данных регулярно становятся узкими местами даже после разумной оптимизации, архитектуру слоя данных, возможно, пора развивать.
Характер трафика не менее важен, чем его средний объём. Система может без проблем работать большую часть дня, но испытывать серьёзную нагрузку во время запуска продукта, выполнения плановых задач, маркетинговых кампаний или внезапных всплесков активности. Нагрузочное тестирование помогает обнаружить такие пределы до того, как с ними столкнутся реальные пользователи.
Требования к надёжности могут оправдывать инвестиции ещё до появления большого трафика. Критически важному бизнес-приложению могут понадобиться резервирование, автоматическое переключение при отказе, более серьёзная система аварийного восстановления или мультирегиональная архитектура не из-за огромного количества запросов, а из-за высокой стоимости простоя.
Размер команды также может стать причиной архитектурных изменений. Монолит способен прекрасно масштабироваться технически, но со временем создавать организационные сложности, если десяткам разработчиков необходимо независимо выпускать изменения в разных частях продукта. В такой ситуации более чёткое разделение сервисов может решать проблему координации, а не проблему трафика.
Главное — воспринимать масштабирование как последовательность реакций на реальные данные.
Начинайте с архитектуры, достаточно простой для понимания и эксплуатации текущей командой. По возможности делайте экземпляры приложения взаимозаменяемыми. Поддерживайте понятные границы между компонентами. Переносите подходящие задачи в асинхронную обработку. Внимательно относитесь к базе данных. Закладывайте наблюдаемость. Тестируйте важные сценарии отказов.
А затем измеряйте.
Когда появляется реальное узкое место, сначала устраняйте самое простое ограничение. Оптимизируйте запрос, прежде чем менять базу данных. Добавьте ещё один экземпляр приложения, прежде чем перестраивать всю платформу. Внедрите очередь до создания сложной событийно-ориентированной архитектуры. Выделяйте отдельный сервис тогда, когда независимое масштабирование или отдельная ответственность действительно дают заметное преимущество.
В конечном счёте проектирование с расчётом на масштабирование с первого дня заключается не в попытке предсказать, насколько большой станет система. Его задача — сделать так, чтобы при реальном росте у команды было несколько разумных способов адаптировать архитектуру вместо необходимости срочно переписывать всё приложение.